读取并比较音频记录
当您在 Media Access Tab(媒体访问标签页) 中为音频设备或音频通道添加读取测试步骤时,会显示此对话框。
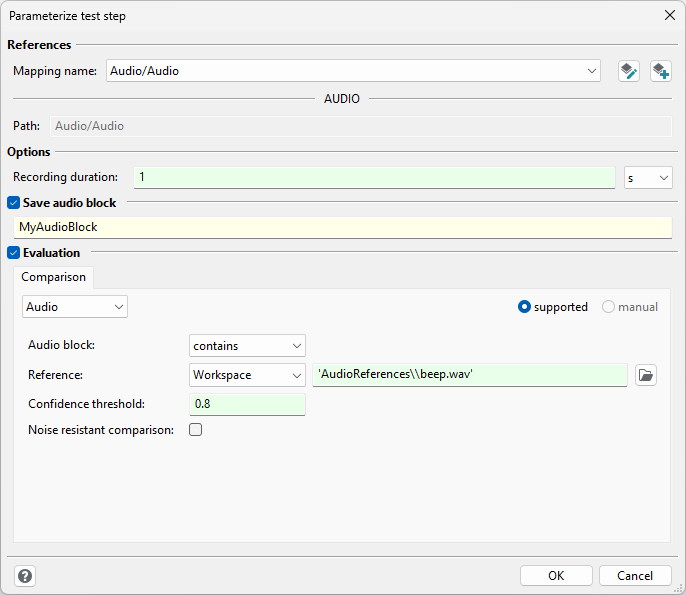
该对话框由四个部分组成:
引用
可在此查看或更改被引用的 mapping item(映射项)。
选项
可在此输入该测试步骤的音频录制时长。
保存音频块
可选地,您可以在此输入 test case variable(测试用例变量)的名称。音频记录将作为 AudioBlock(音频块对象) 保存到该变量中。
评估
在此部分中,您可以设置一个在执行测试用例时进行评估的期望。 可以通过该部分左上角的下拉菜单选择不同类型的期望。
期望类型 Audio
测试步骤采集到的记录将与参考记录进行比较。通过 Audio block旁边的下拉框,可以指定是期望在记录中识别到该参考,还是期望不识别到该参考。
参考记录可以是以下类型:
参考类型 |
有效输入类型 |
示例 |
|---|---|---|
对象 |
|
|
Workspace(工作区) |
以字符串形式指定 Workspace 中的文件路径。支持的文件类型包括 WAV、FLAC、MP3、OGG, 以及 Python 库“soundfile”支持的其他格式。 |
|
评估算法可以通过以下参数进行设置:
Confidence threshold:可定义在音频记录中识别参考时所需的置信度。该值必须位于 0 到 1 之间。 例如,如果比较算法以 0.7 的置信度识别出参考记录,那么当置信度阈值设置为 0.8 时,会认为该参考未包含在记录中。
Noise resistant comparison:如果记录中包含噪声,可通过此设置提升识别效果。对于无噪声的台架配置,不建议启用该选项。
期望类型 String
可以在音频流中识别口语文本,并将其与参考字符串进行比较。speech-to-text 服务可在 test configuration(测试配置) 中进行配置。也可以通过用户代码接入 speech-to-text 服务,这些服务同样会列在测试配置中。更多信息请参见帮助章节 user defined speech recognition(用户自定义语音识别)。
期望类型 Unspecific
也可以直接在此输入评估条件。此处的“value”表示该测试步骤记录得到的 AudioBlock。AudioBlock 对象的接口可参见 AudioBlock(音频块对象)。